
Transcribir audios de WhatsApp solo tiene sentido si el texto resultante alimenta un flujo que extrae datos, cualifica al contacto y actualiza el expediente en el CRM. La transcripción no es el objetivo final, sino la primera pieza de un pipeline que debe generar un resumen, campos estructurados y una alerta de derivación humana cuando el sistema no tiene certeza suficiente. Cualquier despacho que instale esto sin ese disclaimer y sin reglas de escalado está automatizando un riesgo, no una solución.
En resumen:
- La transcripción automática de audios de WhatsApp debe formar parte de un flujo que genere datos estructurados y alertas, no ser una solución aislada.
- Implementar el pipeline completo requiere integrar la API de WhatsApp, un motor de transcripción, un extractor de campos y el CRM en un proceso escalable.
- Es crucial definir un aviso legal, un umbral de confianza y procedimientos de retención para minimizar riesgos y asegurar una derivación adecuada a humanos.
- Medir tiempos de respuesta, tasa de conversión, derivaciones y ahorro de tiempo ayuda a evaluar y optimizar el rendimiento del sistema.
- La automatización efectiva se inicia con un diagnóstico previo y una prueba piloto, priorizando casos con mayor impacto como consultas fuera de horario.
Tabla de contenidos
- Por qué transcribir audios de WhatsApp mejora la captación de leads en despachos
- Arquitectura mínima para convertir audios en texto y volcarlos al CRM
- Aviso legal, límites del agente y umbrales de derivación humana
- Cómo implementar el pipeline: hoja de ruta por fases
- Qué medir para saber si el sistema realmente funciona
- Lo que hemos aprendido implementando esto en despachos reales
- Implementar transcripción y cualificación por WhatsApp con Syntropyhub
- Fuentes
Por qué transcribir audios de WhatsApp mejora la captación de leads en despachos
Un cliente que envía una nota de voz a las 22:00 y recibe respuesta a las 9:00 del día siguiente ya está hablando con otro despacho. Convertir esos audios en texto de forma inmediata permite que un agente automatizado los procese en segundos, algo que ningún equipo humano sostiene fuera de horario. Transcribir mensajes de voz de WhatsApp e integrarlos con el CRM convierte conversaciones dispersas en datos buscables y reduce notablemente el tiempo de gestión por mensaje.
El texto también resuelve un problema que casi nadie menciona: la auditoría. Un audio de 90 segundos no se puede escanear en tres segundos. Un párrafo de texto sí. Eso cambia por completo cómo un despacho revisa expedientes o responde ante una consulta interna sobre qué se dijo y cuándo.
Los usos más habituales una vez integrado el flujo:
- Intake inicial: identificar tipo de caso, urgencia y datos de contacto sin que nadie escuche el audio manualmente.
- Confirmación de citas: transcribir la respuesta del cliente y actualizar el estado en el CRM automáticamente.
- Recordatorios y seguimiento: detectar en el texto si el cliente pide reprogramar o aporta nueva documentación.
Consejo profesional: mide cuántos leads llegan fuera de horario laboral. En la mayoría de despachos ese porcentaje justifica por sí solo la inversión en un pipeline de transcripción automática.
Arquitectura mínima para convertir audios en texto y volcarlos al CRM
El error habitual es tratar la transcripción como un servicio aislado. Funciona como un pipeline con seis piezas que se pasan el dato entre sí, cada una con una responsabilidad concreta.
- WhatsApp Business API (WABA): recibe el audio entrante y dispara el evento inicial.
- Webhook verificado: valida la firma de la petición y encola el mensaje sin bloquear la conversación.
- Cola de medios (FIFO): garantiza que ningún audio se pierda ni se procese fuera de orden, especialmente en picos de tráfico.
- Motor de transcripción: convierte el audio en texto (modelos como Whisper cubren bien español e inglés con acentos variados).
- Extractor de campos con razonamiento: un modelo con capacidad de tool‑calling (tipo GPT) identifica nombre, tipo de caso, urgencia y datos de contacto dentro del texto transcrito.
- Conector CRM: hace el upsert del expediente, evitando duplicados cuando el mismo cliente escribe varias veces.
El flujo, en la práctica, sigue este orden, especialmente al automatizar WhatsApp con inteligencia artificial para empresas:
- El cliente envía el audio por WhatsApp.
- El webhook lo recibe y lo coloca en la cola FIFO sin demora.
- El motor de transcripción genera el texto.
- El extractor identifica campos clave y genera un resumen breve.
- El orquestador decide si el caso avanza automáticamente o requiere revisión humana.
- El conector actualiza el CRM y adjunta transcripción, resumen y metadatos al expediente.
Para el almacenamiento, un pipeline con cola FIFO de medios, subida a Drive y resúmenes acumulativos permite que el equipo abra un único enlace con el historial completo de la conversación y un resumen actualizado, en lugar de rebuscar archivos sueltos. Una estructura sencilla con Google Drive y Google Sheets como capa intermedia cubre bien a despachos que aún no tienen un CRM sofisticado:
| Componente | Función | Ejemplo de herramienta |
|---|---|---|
| Recepción de audio | Captura el mensaje entrante | WhatsApp Business API |
| Transcripción | Convierte voz en texto | Whisper u otro motor ASR |
| Extracción de campos | Identifica datos clave | Modelo con tool‑calling (GPT) |
| Almacenamiento intermedio | Guarda transcripción y resumen | Google Drive + Google Sheets |
| Registro final | Centraliza el expediente | CRM del despacho |
Aviso legal, límites del agente y umbrales de derivación humana
Ningún agente de IA debe sonar como un abogado dando consejo. Es obligatorio, desde el primer mensaje, un aviso que aclare que el sistema no ofrece asesoramiento legal y que la relación profesional solo se formaliza tras revisión de un humano. Esto no es una recomendación cosmética: protege al despacho de responsabilidad y protege al cliente de una falsa sensación de haber recibido consejo vinculante.
La política de «no asesoramiento» se implementa en tres capas:
- Mensaje de apertura: el disclaimer aparece antes de que el cliente comparta cualquier dato sensible.
- Prompts del modelo: instrucciones explícitas que impiden al agente valorar la solidez de un caso o sugerir estrategias legales.
- Umbral de confianza: cuando la extracción de campos o la clasificación del caso caen por debajo de un porcentaje definido, el sistema deriva automáticamente a un humano en lugar de improvisar una respuesta.
Un conflict check efectivo exige revisar en ambas direcciones los datos del CRM antes de agendar cualquier cita; si aparecen coincidencias sospechosas, el flujo se detiene y notifica al equipo humano en lugar de continuar solo.
Consejo profesional: define el umbral de confianza en función del tipo de caso, no de forma genérica. Una consulta laboral sencilla admite un umbral más bajo que una posible incompatibilidad entre clientes.
Las transcripciones contienen datos personales y a veces sensibles. Conviene fijar un plazo de retención razonable, restringir el acceso solo a quien gestiona el expediente y documentar quién puede consultar el historial completo.
Cómo implementar el pipeline: hoja de ruta por fases
Empezar por todo a la vez es la forma más rápida de que el proyecto no despegue. Un despliegue realista tiene cuatro fases.
- Fase 0, diagnóstico: mapear cuántos leads llegan por WhatsApp, qué CRM se usa hoy y qué volumen de audios se recibe al mes. Sin este dato, cualquier estimación de impacto es una suposición.
- MVP técnico: conectar la WhatsApp Business API, el webhook, la cola de medios y el motor de transcripción, con un resumen automático y un upsert básico en el CRM. Esta versión ya debe producir expedientes legibles sin intervención manual.
- Automatizaciones adicionales: sumar extracción de campos más precisa, verificación de conflicto de intereses y agendamiento directo de citas desde la conversación.
- Validación y despliegue: probar con un volumen real limitado antes de abrir el flujo a todos los canales del despacho.
Entregables mínimos que conviene exigir antes de dar por cerrado el MVP:
- Transcripción legible con marca de tiempo y remitente identificado.
- Resumen de 3 a 5 líneas por conversación, no solo el texto crudo.
- Campo de urgencia y tipo de caso poblado automáticamente en el CRM.
- Alerta visible cuando el sistema deriva un caso a revisión humana.
En proyectos similares, incorporar conflict check y agendamiento dentro del mismo flujo ha permitido bajar el tiempo de intake de 10 a 15 minutos hasta unos 3 minutos por caso, un salto que se nota especialmente en despachos con alto volumen de primeras consultas.
Qué medir para saber si el sistema realmente funciona
Instalar el pipeline sin medirlo es trabajar a ciegas. Cuatro métricas cubren tanto el rendimiento como el riesgo:
- Speed‑to‑lead: minutos entre la recepción del audio y la primera respuesta útil al cliente.
- Conversión de lead a cita: porcentaje de contactos transcritos que terminan agendando una consulta.
- Porcentaje de derivaciones por baja confianza: cuántos casos el sistema envía a un humano por no alcanzar el umbral fijado.
- Tiempo humano ahorrado: minutos que el equipo dejó de dedicar a escuchar audios y transcribir manualmente.
Dato relevante: cuando el flujo de transcripción alimenta directamente el CRM, el ahorro de tiempo por mensaje es sustancial, según documenta VOCAP, porque elimina la escucha manual y la transcripción improvisada por parte del equipo.
Conviene configurar alertas para tres fallos críticos: la cola de medios se atasca, el motor de transcripción devuelve errores repetidos, o el upsert al CRM falla y duplica expedientes. Cualquiera de los tres, sin monitoreo, genera pérdida silenciosa de leads.
La auditoría humana no debe desaparecer solo porque el sistema funcione bien la mayoría del tiempo. Revisar una muestra semanal de transcripciones y derivaciones automáticas permite detectar sesgos o errores de extracción antes de que afecten a un volumen grande de casos.
Lo que hemos aprendido implementando esto en despachos reales
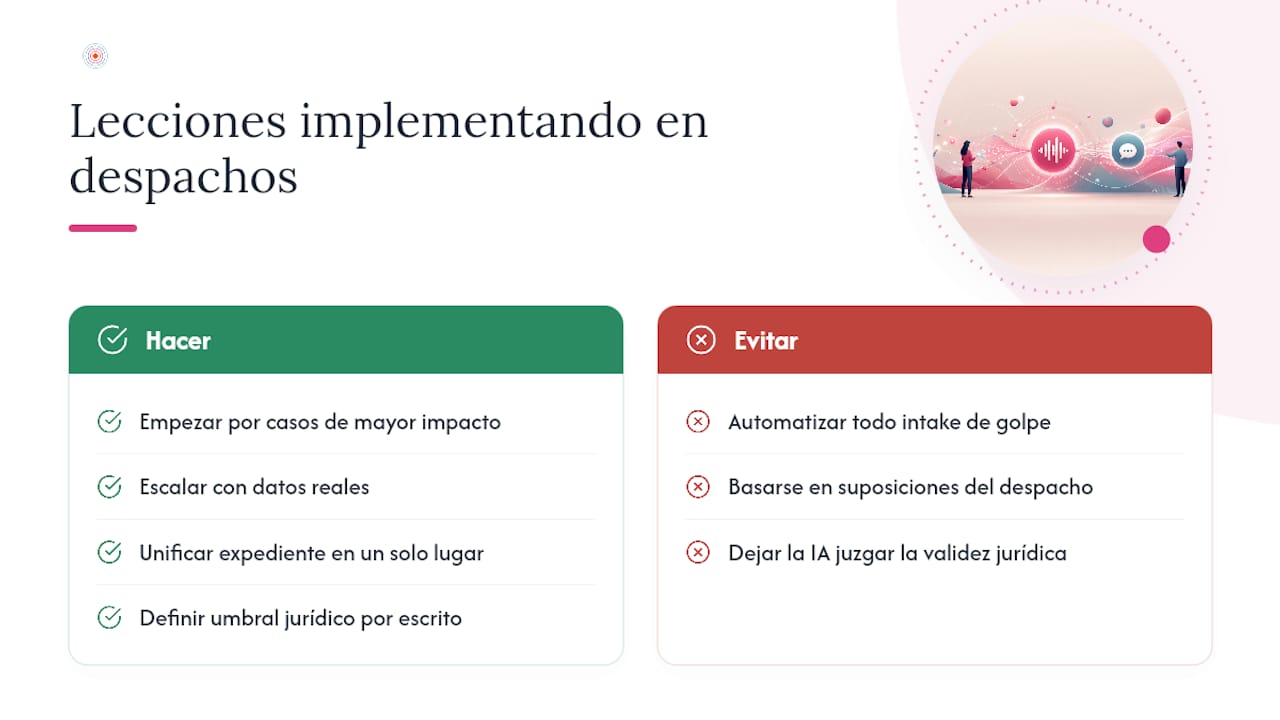
La tentación es automatizar todo el flujo de intake de golpe. No funciona así. Lo que da resultados es elegir el caso de mayor impacto (normalmente, las consultas fuera de horario) y escalar desde ahí con datos reales, no con suposiciones sobre lo que el despacho «cree» que necesita.
El expediente único importa más de lo que parece al principio. Un abogado que retoma una conversación necesita ver audio, transcripción, resumen y campos extraídos en un solo lugar, no en tres pestañas distintas. Y el límite más importante sigue siendo el mismo: la IA recopila, filtra y prioriza, pero nunca evalúa la solidez jurídica de un caso. Ese umbral hay que definirlo por escrito antes de encender el sistema, no después del primer error.
— Carolina
Implementar transcripción y cualificación por WhatsApp con Syntropyhub
Montar este pipeline desde cero exige integrar la WhatsApp Business API, un motor de transcripción, un extractor de campos y el CRM.

El proceso empieza con un diagnóstico del volumen real de leads por WhatsApp y del CRM que ya usa el despacho, sigue con un MVP operativo en semanas y continúa con iteraciones basadas en métricas de speed‑to‑lead y conversión. La política de disclaimer y los umbrales de derivación humana se configuran desde el primer día, siguiendo el mismo enfoque que aplicamos en nuestra recepcionista IA para despachos legales.
Si tu despacho recibe audios de WhatsApp que hoy se escuchan uno a uno, solicita una demo de la recepcionista virtual con IA y revisa en vivo cómo quedaría tu propio flujo de intake automatizado.